SPECS 项目生成器
给 AI 立规矩的研发协作套件 —— 选 Agent 与技术栈,下载成体系的项目文件
项目信息
选择 AI 工具
选择技术栈
预览:将生成的文件
30 秒看懂这套体系
画面由代码逐帧渲染合成,与下方导览讲的是同一套流转。
谁在做什么 —— 四位角色 + AI 的完整旅程
按 ①→⑫ 推进一个需求的完整旅程:产品甲 / 产品乙 / 研发甲 / 研发乙四条泳道,谁的步骤谁点亮;右侧常驻「AI 在做什么」。流程与协作手册的流程图一致。「视频模式」可拖动进度,「交互模式」点任意步骤直接跳转细看;mp4 可下载。
下载 ZIP 之后怎么用
从生成器页面下载的 {项目名}-specs.zip,里面是一套给产品、研发和 AI 编程工具(Claude Code、Cursor、Codex CLI 这些,下文统称 Agent)共用的项目管理文件:需求怎么记录、怎么确认、怎么变更、提审前查什么。它不是代码脚手架——解压后没有 package.json,没有 requirements.txt,没有任何业务代码,也没有部署配置。代码和部署由你们的项目自己建立,这套文件管的是需求和协作。
思路用一句话说:把决定落在版本化的文档里,而不是散在聊天记录里。Agent 每次干活按入口文件的指引去读对应文档,拿到的是当前项目的最新事实;换人、换会话、甚至换一个 Agent 工具,都能接着干。
解压
新项目
mkdir my-project && cd my-project
unzip my-project-specs.zip
git init && git add -A && git commit -m "init: 项目管理文件"
文件直接放在项目根目录,这里之后就是你的代码仓库。建议第一时间 git init,整套流程依赖版本历史留痕。
已有项目
选"已有项目"生成的 ZIP,所有文件都套在 starter-kit-adoption/ 目录下——这是故意的,防止覆盖你仓库里已有的 CLAUDE.md、.gitignore 等文件。解压到仓库根目录即可,后续怎么接入见下文"老项目怎么走",不要直接把文件拷到根目录。
目录结构
以选择 Claude Code + Cursor、技术栈 FastAPI + Vue 为例:
my-project/
├── CLAUDE.md                  # Claude Code 的项目入口
├── .cursorrules               # Cursor 的项目入口,内容同 CLAUDE.md
├── .gitignore                 # 通用忽略规则(编辑器、env、依赖、构建产物)
├── .ai/                       # 流程和规范,干什么活读什么
│   ├── SPECS-WORKFLOW.md      # 需求录入、确认、变更的完整流程
│   ├── PROMPT-USAGE.md        # 各阶段的对话提示词示例
│   ├── TECH-STANDARDS.md      # 技术基线,待研发填写
│   ├── DESIGN-STANDARDS.md    # 设计基线,待产品/设计填写
│   ├── TEST-STRATEGY.md       # 测试样例怎么建立和维护
│   ├── REVIEW-GATE.md         # 提审前的深度 Review 要求
│   ├── WORKTREE-WORKFLOW.md   # 多人并行开发的 worktree 约定
│   ├── ADOPT-EXISTING.md      # 老项目接入流程,新项目用不到
│   ├── KIT-VERSION.md         # 生成时的 kit 版本,升级对照用
│   ├── UPDATE-LOG.md          # 文件系统的逐版变更记录
│   └── prompts/
│       ├── fastapi-guide.md   # 选中的技术栈指南,用哪个栈读哪个
│       ├── vue-guide.md
│       ├── prototype-guide.md # 原型制作指南,跟技术栈无关
│       └── design-craft.md    # 通用界面手法和自检清单,做界面 / 审 UI 时读
├── .specs/                    # 模板和清单,创建或审查产物时才读
│   ├── templates/             # Spec、Plan、Tasks、测试样例等 6 个模板
│   └── checklists/            # Spec、Plan、Code 三份自检清单
└── specs/
    └── project-overview.md    # 项目总览,已填入你的一句话描述
入口文件由你勾选的 Agent 决定(Claude Code、ZCode 得 CLAUDE.md,Codex、OpenCode 得 AGENTS.md,Qoder 得 .qoder/rules/project_rules.md,Trae 得 .trae/rules/project_rules.md……),勾了几个就有几份,内容一样。另外四个目录现在不存在、后面会用到:specs/history/(Spec 快照及当期归档的图和报表,确认基线时建)、tests/cases/(测试样例)、prototypes/(原型,按 {模块} 分子目录)和 generated/(确认时对照用的生成物:由 Spec 生成的操作路径图、ER 图、接口定义,以及从代码逆向导出的表结构和接口列表;已加入 .gitignore,随删随生成,基线确认时把关键产物归档进 specs/history/)。
每个文件是做什么的
| 文件 | 里面是什么 | 谁读、何时 |
|---|---|---|
入口文件(CLAUDE.md 等) |
项目名、描述、技术栈和任务路由,生成时已填好 | Agent 每次会话自动读 |
.ai/SPECS-WORKFLOW.md |
需求建档规则、状态流转(草稿→待产品确认→待研发校准→已基线→实施中→已验收)、基线与快照做法、需求变更流程、"要不要写 Plan"的判断标准 | 产品、研发,录入和变更需求时 |
.ai/PROMPT-USAGE.md |
七个阶段的现成提示词(接入、录入、变更、原型、校准、测试、Review) | 所有人,不知道怎么跟 Agent 说时 |
.ai/TECH-STANDARDS.md |
框架版本、包管理、lint/test/build 命令、目录边界、API 和数据库约定;初始是待确认表格,研发填完就是编码依据 | 研发,开工前核对、改约定时更新 |
.ai/DESIGN-STANDARDS.md |
目标用户和设备、组件库、表单表格弹窗约定、文案语气 | 产品 / 设计,做原型、审界面时 |
.ai/TEST-STRATEGY.md |
测试样例怎么建、怎么跟 F/AC 挂钩、废弃规则、执行结果怎么记录 | 产品、研发,写样例和执行验证时 |
.ai/REVIEW-GATE.md |
提审前四条深查路径(需求与契约、失效与安全、变更影响、验证证据)和放行标准 | 提审的研发,提 PR / MR 前 |
.ai/WORKTREE-WORKFLOW.md |
多人并行时 worktree 的建立、集成和清理命令 | 研发,多人同时改动时 |
.ai/ADOPT-EXISTING.md |
老项目盘点和逐项接入的流程 | 研发,接入已有仓库时 |
.ai/KIT-VERSION.md |
生成这套文件时的 kit 版本标记 | 升级 kit 或排查文件差异时 |
.ai/UPDATE-LOG.md |
文件系统每个版本改了什么的变更记录 | 升级 kit 时先读它确定影响范围 |
.ai/prompts/技术栈-guide.md |
对应技术栈的默认编码约定(分层、Schema、事务、测试等) | 研发,写对应栈的代码时 |
.ai/prompts/prototype-guide.md |
原型制作的步骤和交付物要求 | 产品 / 设计,做原型时 |
.ai/prompts/design-craft.md |
通用界面设计手法(层级、间距、色彩、状态等,提炼自《Refactoring UI》)和提审自检清单 | 产品 / 设计 / 研发,做界面、审 UI 时;不使用 Agent 的同学可直接当设计手册 |
.specs/templates/(6 个) |
Spec(版本表、F 表、AC 表、技术校准、未决问题)、Plan、Tasks、测试样例、项目总览、老项目盘点,各一份格式模板 | Agent 创建对应产物时套格式 |
.specs/checklists/(3 份) |
Spec 交接自检、Plan 自检、研发自检清单 | 交接或提审前过一遍 |
specs/project-overview.md |
项目描述、负责人、模块索引和待确认事项 | 所有人随时 |
specs/M{N}-xxx.md、specs/history/ |
运行中产生:每个模块一份 Spec,每个确认版本一份只读快照 | 所有人,这是项目需求的事实 |
tests/cases/ |
运行中产生:与 Spec 版本、F/AC 对应的测试样例 | 产品、研发 |
核心原则:入口常驻,.ai/ 按任务读,.specs/ 当格式参考,specs/ 是实际内容。不需要通读所有文件再开工。
怎么和 AI 交互
不管什么角色,说话时记住三点:说清当前目标和依据(Spec 版本、需求来源);让 Agent 自己去读对应的 .ai/ 文档,不要把规范粘贴进对话;结论要落回文件,聊天记录不算数。下面的提示词直接改写花括号就能用,更多见 .ai/PROMPT-USAGE.md。
产品:录入需求、变更、验收
新需求,收到就建档,信息不全也先建:
我收到 {来源/日期} 的需求:{原始诉求}。请按
.ai/SPECS-WORKFLOW.md和 Spec 模板建立specs/M1-文档管理.md,保留原话,整理用户场景、业务规则、F/AC 编号和未决问题,不知道的标"待确认",不要编接口和数据表。先给我看业务部分。
需求变更,在同一份 Spec 里加版本,不动旧快照:
在 M1 的 v1.0 基础上新增批量导出,来源是 {来源/日期}。请写变更记录:旧行为、新行为、原因、受影响的 F/AC 和测试样例,状态回到待研发校准。
验收:
按 M1 v1.0 的 AC 逐项验收文档管理功能,记录通过、失败或未验证及证据;业务偏差更新 Spec 的未决问题,不留口头结论。
设计 / 原型
基于 M1 v1.0 的 F/AC,读
.ai/DESIGN-STANDARDS.md和.ai/prompts/prototype-guide.md,制作文档管理页面原型,覆盖正常、加载、空、错误、无权限状态,交付页面清单和与 F/AC 的对应关系。
原型反馈如果改变了业务行为,先回写 Spec 再更新原型。
研发:校准、实现、修复
技术校准:
基于已确认的 M1 v1.0,检查现有代码和
.ai/TECH-STANDARDS.md,校准接口、数据、权限和测试方案,写进 Spec 技术附录;业务冲突列出来交产品确认。
实现:
按已基线的 M1 v1.0 实现,遵循技术基线和
.ai/prompts/fastapi-guide.md,完成后报告变更文件和验证结果。
局部修复(不改变用户行为、不动接口和数据结构的,不用动 Spec,直接改):
修复上传接口的空指针,补一个针对性验证,说明影响范围。
Plan 和 Tasks 只在跨模块依赖、不可逆迁移、重要取舍或多人并行时写:
为 M1 写简短 Plan:现状、方案、文件归属、风险和验证方式。
测试:建样例、执行
按
.ai/TEST-STRATEGY.md为 M1 v1.0 的 F/AC 在tests/cases/建立样例,覆盖主路径、权限和数据边界,用测试样例模板。执行 M1 受影响的样例和必要回归,记录环境、命令、结果和失败证据;区分"未执行"和"失败"。
Review:提审前
按
.ai/REVIEW-GATE.md审查 M1 分支相对 main 的 diff,依据 Spec v1.0 的 F/AC、测试样例和技术基线,检查需求遗漏、权限、边界、兼容和回滚;先列问题清单,再报告验证结果和是否满足提审条件。
PR 描述里写清 Spec 版本、测试结果和遗留风险,尽量让没写这段代码的人做第二遍审查。
多人并行时按 .ai/WORKTREE-WORKFLOW.md:每人独立 branch + worktree,先分好文件归属,需求变化先回 Spec 再同步各分支。
新项目怎么走
- 解压、
git init(见上文)。 - 研发负责人填
.ai/TECH-STANDARDS.md,产品 / 设计填.ai/DESIGN-STANDARDS.md。可以直接让 Agent 起草:「检查项目当前依赖和目录结构,把技术基线的真实版本和命令填上,不确定的标待确认」,填完由对应负责人确认。 - 补
specs/project-overview.md的用户和场景(生成时只填了一句话描述),列出已知模块,未知标"待确认"。 - 之后每个需求走同一条线:产品录入 → 产品确认业务 → 研发校准 → 双方确认基线 → 实现 → 测试 → Review 提审 → 产品验收。状态从"草稿"一路走到"已验收",流转规则在
.ai/SPECS-WORKFLOW.md。
确认基线是关键动作,操作就两步:在 Spec 的"版本与变更"表里写下版本号、确认人、日期和快照路径;把整份文件复制到 specs/history/M1-document/v1.0.md(目录没有就建)。快照从此只读,后续修订只改当前文件。到这里 Spec 才成为可以开工的契约。让 Agent 代做检查、填表和复制的提示词,见 .ai/PROMPT-USAGE.md 第 5 阶段的"确认基线时"。
中途需求变了:在同一份 Spec 里加版本和变更记录,旧快照不动,状态回到"待研发校准"。哪怕改动很小,只要用户可见的行为变了就走这条路;不改变行为的技术修复直接改代码。
老项目怎么走
- 盘点。解压出
starter-kit-adoption/后让 Agent 读里面的.ai/ADOPT-EXISTING.md:
请按
starter-kit-adoption/.ai/ADOPT-EXISTING.md盘点这个仓库,用盘点模板建立.specs/adoption-inventory.md,每项结论附文件路径或命令证据,无法验证的标"待确认"。先提逐项接入方案,不要覆盖已有文件。
同时让研发把盘点出的真实版本和命令填进 .ai/TECH-STANDARDS.md,技术栈指南降级为待校准的建议。
-
业务基线。从已有功能提炼候选模块和 F/AC,作为"代码观察"记录;产品确认业务意图后写成正式 Spec 并存首次快照。观察到的行为(包括缺陷)不能自动当成批准的需求。
-
安装与验证。在独立分支或 worktree 上逐项比较暂存包与仓库同名文件:入口文件合并路由和链接、保留原有指令,
.gitignore只追加需要的规则,已有 Spec 和部署配置不自动替换;每项的采纳 / 合并 / 跳过决定记在盘点表里。验证入口链接和检查命令可用后,清理starter-kit-adoption/。
用过旧版模板的项目同样走这条路:先比较根目录同名文档里的定制内容再迁入 .ai/,更新引用、确认无旧路径残留后删旧副本。
关于部署
ZIP 里没有部署内容——没有 Dockerfile、CI 配置或上线脚本,生成器也不生成这些。两点和部署相关的说明:
- 老项目接入流程里说的"部署",指的是把这套管理规则部署进你的仓库;软件上线仍按项目现有的发布流程执行。
- 上线前想要一份检查清单,可以在
.ai/或specs/里自己维护一份(目标版本和负责人、配置与密钥、数据迁移兼容、健康检查、回退步骤),并让 Agent 在发版前按清单核对。部署目标和兼容性要求也应记录在.ai/TECH-STANDARDS.md的项目约定里。
如何扩展这套体系
下载后所有文件都是你们团队的,随便改。要守住的只有两条:入口文件里引用的路径真实存在;改了文档之间的交叉引用要同步。两类常见扩展:
加自己的技术栈(生成器列表里没有的,比如 Django、Go、React):
- 照现有指南的结构写一份
.ai/prompts/{stack}-guide.md:开头一句"仅在研发 X 部分时读取",中间放默认约定(分层、契约、数据、测试,几条就够),结尾写首次使用时要向技术基线确认什么。 - 入口文件"使用已选技术栈的指南"那一行加上新路径。
- 改
.ai/TECH-STANDARDS.md开头的技术栈名称并填真实版本。记住次序:指南只是默认做法,技术基线才是权威——最省事的情况下只做第 3 步也能正常运转。
加自己的提示词:
- 分阶段、分角色的提示词并进
.ai/PROMPT-USAGE.md对应阶段,或放.ai/prompts/新文件;每份写清"什么情况下读我",在入口路由加一行,不要整段塞进入口文件。 - 工具原生资产(Claude 的 skills 和 commands、Cursor 规则、MCP 服务)可以和这套文件共存:保持原生触发机制,在入口路由里加一句说明它们的存在和适用场景;项目的事实约束写在基线文档里,不写进提示词。
- 一条原则:同一条规则别同时活在提示词和基线文档里。事实(版本、命令、约定)归
TECH-STANDARDS/DESIGN-STANDARDS,提示词只负责让 Agent 去读哪个文件、问什么问题,否则两边会慢慢打架。
修改入口文件(多 Agent 团队):入口文件通常只维护一份母本(比如 CLAUDE.md),加路由、改指南索引都可以。如果项目里同时有多份入口(.cursorrules、AGENTS.md 等),改完母本后让 Agent 同步一次:
我更新了 CLAUDE.md 的任务路由和指南索引。请把同样的修改同步到 .cursorrules 和 AGENTS.md,保持各入口内容一致,改完列出差异让我确认。
同步是低频操作,所以有意不写进入口文件的常驻规则,避免每次会话白耗一段 token;需要时用上面这句话触发一次即可。个别工具如果要求自己的入口格式,允许那份入口有合理差异,让 Agent 同步时说明。
升级 kit 版本:.ai/KIT-VERSION.md 记录了当前文件对应的 kit 版本,.ai/UPDATE-LOG.md 记录每个版本改了什么。出新版 kit 后,先读日志确定这个区间动了哪些文件,再逐项比对合并(按老项目接入的方式,不整包覆盖定制内容),合并完把两个文件都更新到新版本。
常见问题
解压后跑不起来? 包里本来就没有代码,它管的是需求和协作,代码由你们和 Agent 按流程写。
团队里有人用 Claude Code,有人用 Cursor?
生成时都勾上就得到两份入口。已经下载了的话,把 CLAUDE.md 复制改成对应工具的文件名(.cursorrules、AGENTS.md 等)即可,内容一样。多份入口修改后怎么保持一致,见"如何扩展这套体系"。
技术栈勾错了或者想加一个?
.ai/prompts/ 下的指南就是普通文件,从生成器重新拿一份补上或删掉,同步入口文件里的指南链接。指南只是默认做法,真正依据是 .ai/TECH-STANDARDS.md。列表里根本没有的栈怎么自己加,也见"如何扩展这套体系"。
快照(specs/history/)必须做吗?
必须。确认基线时留快照,后面有争议才有得对照,Review 时也会核对。操作就是复制文件,也可以直接用 .ai/PROMPT-USAGE.md 里的基线确认提示词让 Agent 代做。
tests/cases/ 是自动化测试代码吗? 不全是。样例记录前置、步骤和预期,可以是自动化用例也可以是人工步骤;自动化的部分由研发落到单元、集成或端到端层。"有样例"和"跑通过"是两回事,分开记录。
每个需求都要写 Plan 吗?
不用。判断标准见 .ai/SPECS-WORKFLOW.md 的"研发工作量判断"。
名词说明
- Spec:一份模块需求文档(
specs/M{N}-{name}.md),含场景、业务规则、验收条件、版本历史和技术附录。 - F 编号:用户场景编号(F01、F02…)。
- AC 编号:验收条件编号,对应某条 F,写"可观察的通过条件"。
- 基线:产品与研发共同确认"就按这个版本做"的 Spec 版本。
- 快照:确认基线时复制到
specs/history/的只读副本,之后不再修改。 - 契约:接口、数据结构等研发双方确认过的技术约定;不改变契约的局部修复不用动 Spec。
- Plan:跨模块或高风险改动的技术方案文档;Tasks:多人协作的任务清单。
- worktree:Git 的多工作区机制,多人并行时每人一个独立目录,互不踩脚。
四人团队研发协作手册(2 产品 + 2 研发)
本手册说明一个真实研发项目基于本 kit 文件体系怎么跑:从项目启动、需求录入、并行开发、合并管理,到发布上线与问题回流。面向 2 产品 + 2 研发的小团队;人数不同时按同样的原则增减角色映射。
规则细则以 .ai/ 内文档为准:需求流程见 .ai/SPECS-WORKFLOW.md,提审标准见 .ai/REVIEW-GATE.md,并行开发命令见 .ai/WORKTREE-WORKFLOW.md,测试样例见 .ai/TEST-STRATEGY.md,界面设计手法见 .ai/prompts/design-craft.md(不使用 Agent 的同学可直接当设计手册),各阶段提示词见 .ai/PROMPT-USAGE.md。本手册是四人团队操作视角的串讲与补充。
人物设定:产品甲、产品乙、研发甲、研发乙。甲组(产品甲 + 研发甲)负责一组模块,乙组(产品乙 + 研发乙)负责另一组模块。
0. 七条铁律
后面所有流程都是这七条的展开,先记住它们:
- 文件即事实:所有决定落版本化文件。聊天、口头、会议结论不算数,当天回写 Spec 或决策记录。
- 单一事实源:一条用户需求只活在一个 Spec 文件里。需要别人知道,用引用(模块名 + 版本号),不用复制。
- 版本线性追加:Spec 的每次改动 = 加版本 + 变更记录。已确认的快照(
specs/history/)只读,永不修改、永不删除。 - 模块负责人制:每份 Spec 只由该模块的产品负责人录入和验收、研发负责人校准和实现。别人的输入通过模块负责人落地。
- 交叉审核:代码审查、发布核对尽量由没写的人复核——当事人已经接受过一次结果,再查往往只是重复确认。局部修复可自查;不得不自查时,换新会话按 Spec 审,并如实记录。
- 先契约后实现:跨模块变更先定下接口、数据结构这些双方约定(契约),各方再动手实现;合并顺序同理。
- 小步提交:建档即提交;改前拉取,改完立刻推送。把冲突窗口压到分钟级。
1. 总览:项目的一条主线
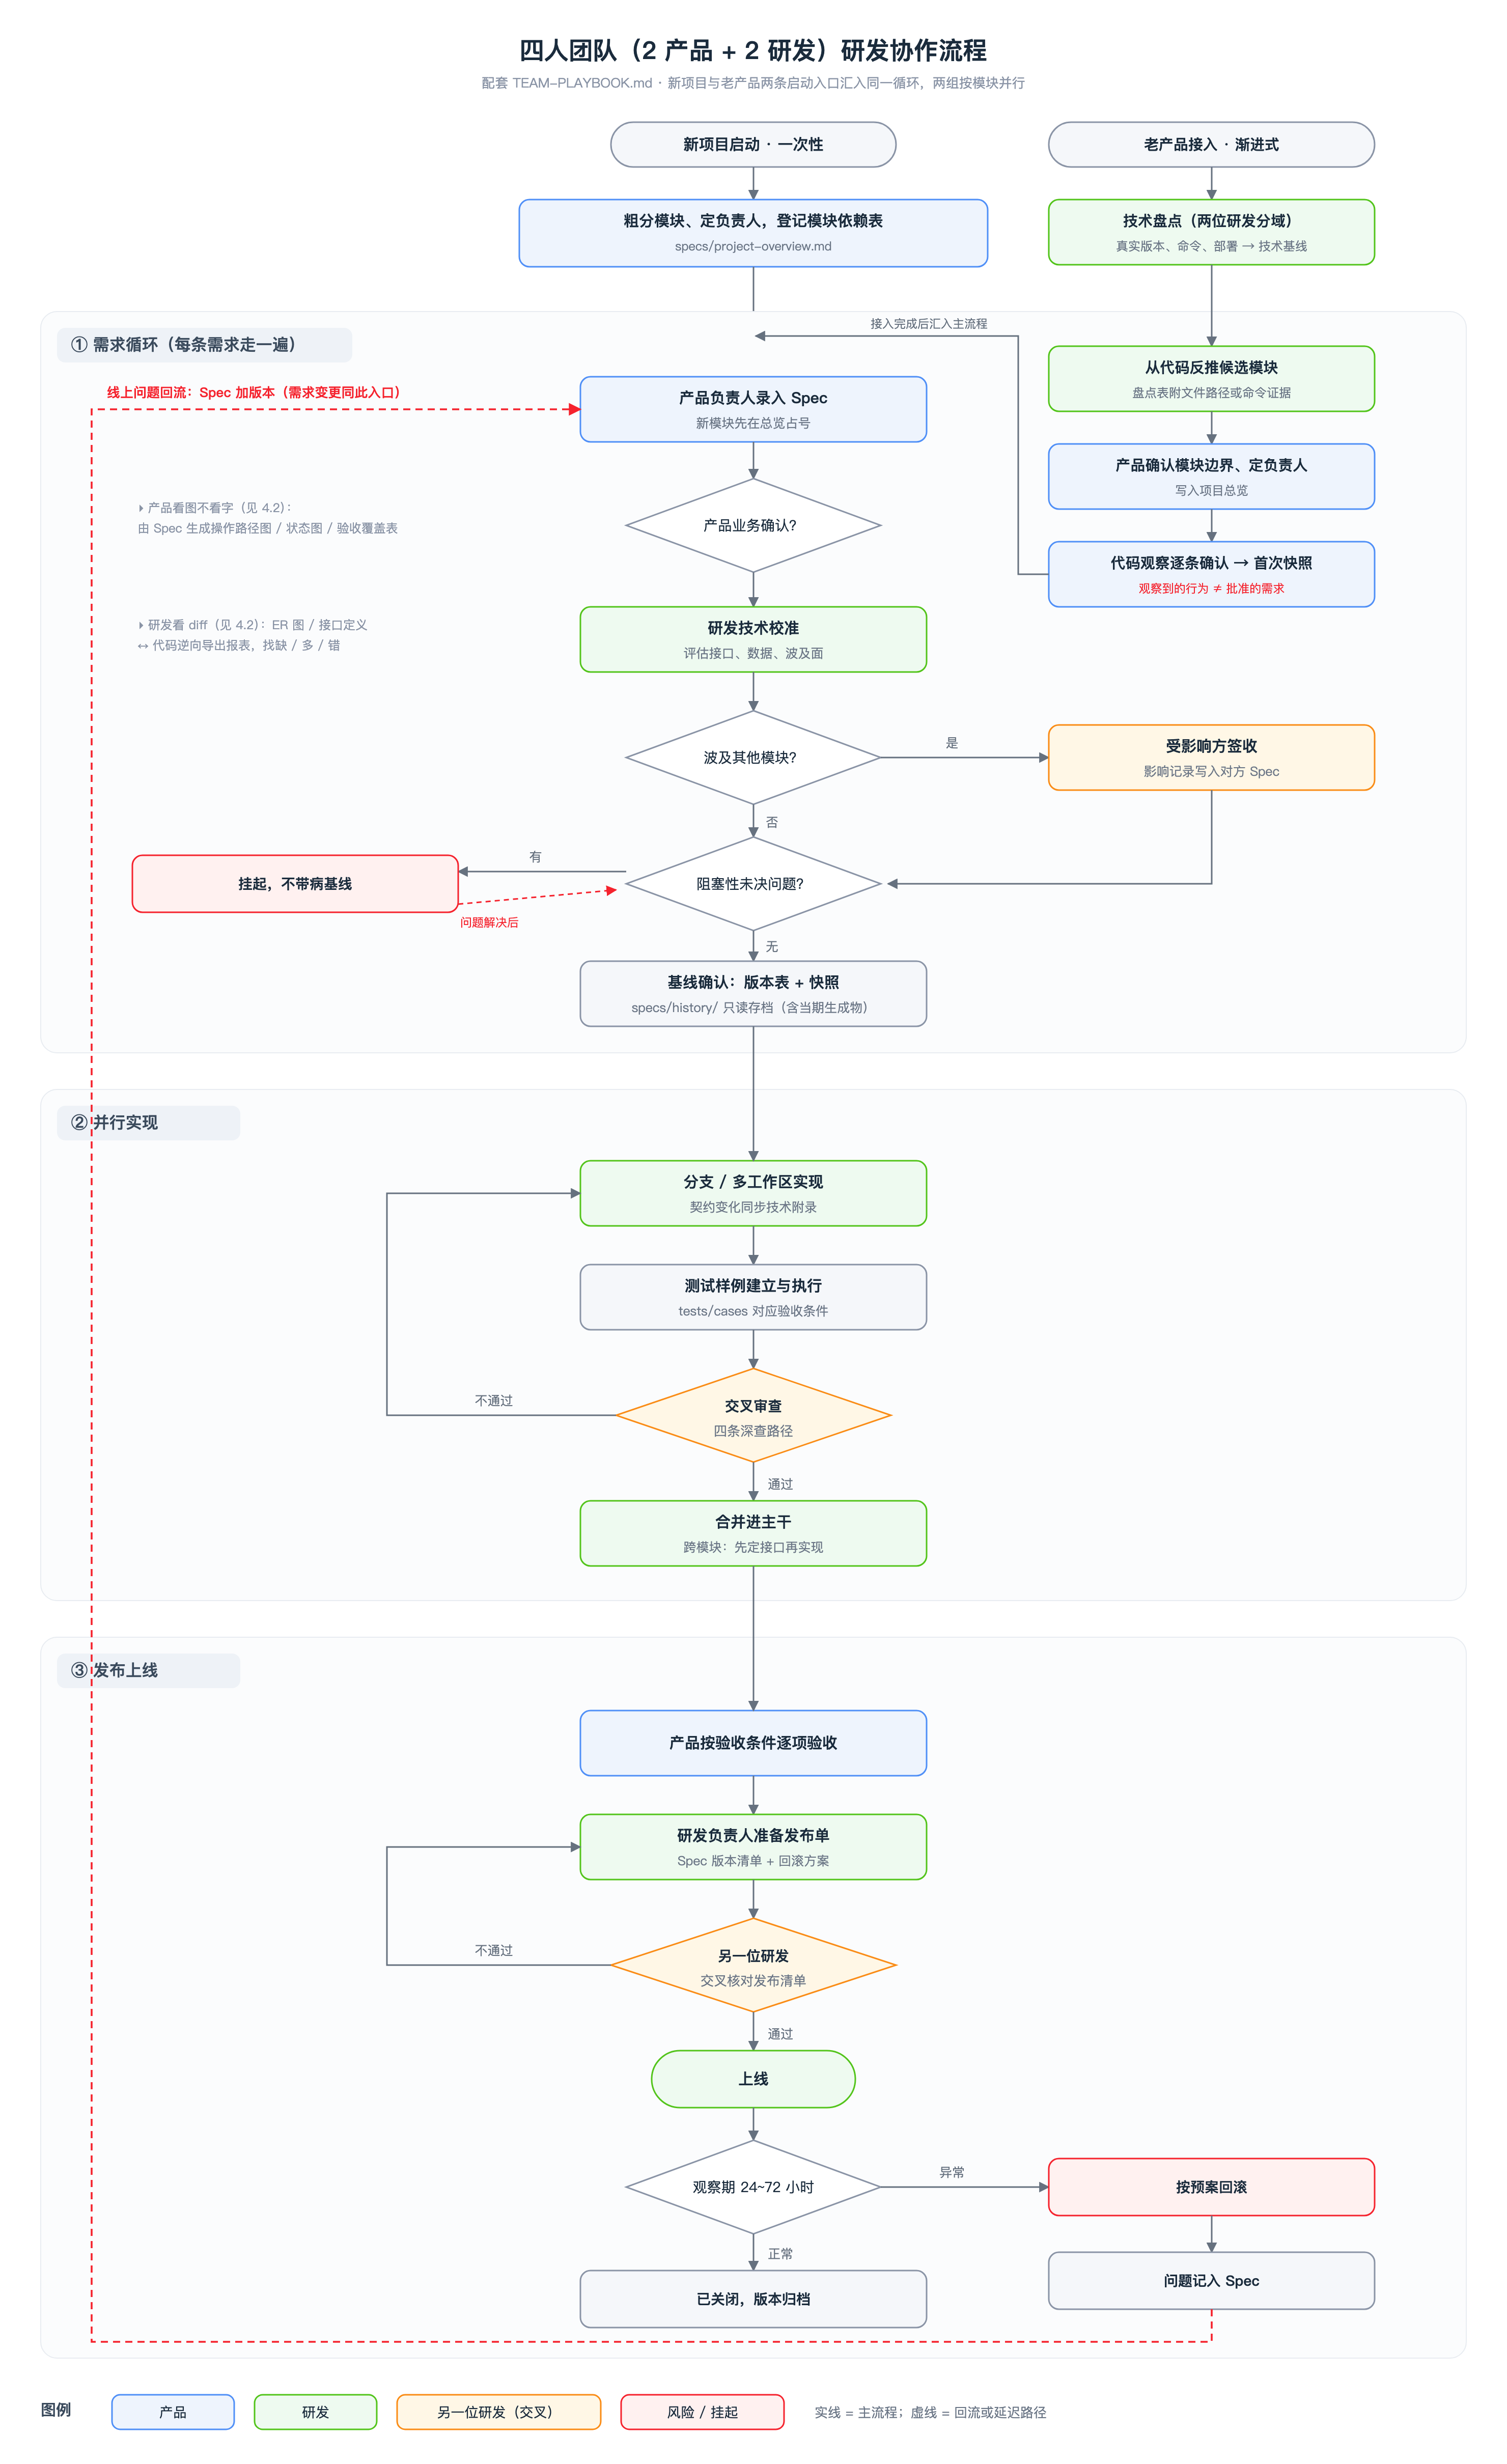
(图片源文件 TEAM-PLAYBOOK-FLOW.svg,修改后可用无头浏览器重新导出 PNG;下面保留文字版,便于终端环境查看。)
项目启动(一次性)  划模块、定负责人 → specs/project-overview.md
      ↓
需求循环(持续)    录入 → 产品确认 → 研发校准 → 基线确认
      ↓                        (跨模块:申报 → 签收,见第 6 节)
并行实现(持续)    分支/多工作区 → 实现 → 测试样例 → 审查 → 合并
      ↓
发布上线            发布单 → 三道门核对 → 上线 → 观察期 → 关闭
      ↓
回流闭环            线上问题 → Spec 新版本 → 回到需求循环
Spec 状态机:
草稿 → 待产品确认 → 待研发校准 → 已基线 → 实施中 → 已验收
     → 待发布 → 已发布 → 观察期 → 已关闭
前六态是 kit 现有定义;后四态是本手册对发布环节的扩展(第 7 节)。
2. 启动:两条入口,同一个循环
新项目走 2.1(半天到一天);老产品——已有代码、已有线上用户的仓库——走 2.2(渐进式)。两条路殊途同归,最后都汇入第 4 节的需求循环。
2.1 新项目启动
负责人牵头(建议产品甲,或团队商定)做四件事:
- 从生成器下载压缩包,解压、
git init、首次提交。 - 研发甲填
.ai/TECH-STANDARDS.md(真实版本、包管理、检查/测试/构建命令、目录边界、接口与数据库约定);产品甲填.ai/DESIGN-STANDARDS.md。可以让 Agent 起草,负责人确认。 - 粗分模块并定负责人,写入
specs/project-overview.md:
| 模块 | 内容 | 产品负责人 | 研发负责人 |
|---|---|---|---|
| M1 文档管理 | 上传、导出、权限 | 产品甲 | 研发甲 |
| M2 消息通知 | 站内信、事件触达 | 产品乙 | 研发乙 |
未知的模块标"待确认",不强行规划。 4. 在项目总览里登记模块依赖表(谁消费谁的事件 / 接口 / 数据),供变更时评估波及面(第 6 节)。
注意:粒度到"已知模块清单"即可。模块会随需求自然生长(占号规则见 4.1),规划错了随时改——项目总览是活文件,不是一次定死的蓝图。
2.2 老产品接入(渐进式,随业务迭代铺开)
与新项目的差别一句话:模块不是规划出来的,是从现有代码反推的;观察到的行为不等于批准的需求。细则见 .ai/ADOPT-EXISTING.md,本节是四人分工视角的执行版(流程图右上角即这条路径)。
前置:用生成器选「已有项目」重新生成,解压出的 starter-kit-adoption/ 暂存目录放仓库根目录,让 Agent 按接入流程逐项比较合并,不直接覆盖仓库里已有的同名文件。
| 步骤 | 谁 | 动作 | 产出 |
|---|---|---|---|
| 1 技术盘点 | 两位研发(分域) | 盘点真实框架版本、包管理、构建 / 测试命令、目录边界、部署路径;已有的发布流程和持续集成记录为现状事实 | 技术基线 + 部署事实 |
| 2 候选模块提炼 | 两位研发 | 按业务域从代码反推候选模块清单,建盘点表,每项附文件路径或命令证据,验证不了的标"待确认" | 盘点表 |
| 3 边界与负责人 | 两位产品 + 负责人 | 产品按业务确认模块边界(候选可合并 / 拆分),然后照 2.1 定负责人。代码结构只是输入,业务归属产品说了算 | 项目总览 |
| 4 业务基线 | 各模块产品 + 研发负责人 | 从代码提炼场景与验收条件,作为"代码观察"草稿;产品逐条确认:一致 → 写入正式 Spec;不一致 → 记偏差,产品决定固化还是立变更。确认完存首次快照 v1.0(现状基线) | 各模块 Spec v1.0 |
| 5 试跑再铺开 | 全员 | 先选 1~2 个高频模块完整走一轮需求循环,验证顺了再批量处理剩余模块;不停业务做全量接入 | — |
老产品专属的三条注意:
- 别把代码行为直接抄成需求。观察到的行为(包括缺陷)不自动成为批准的需求,每条都要产品过目——跳过这步,以后没人分得清哪些是故意的、哪些是缺陷。
- 别推倒已有制度。老项目现存的分支规范、发布流程先记录为现状、按现状运转;要改,等接入完成后走正常变更。
- 别全量铺开。战线太长会把业务迭代卡死,优先高频模块,边接入边交付。
3. 分工
3.1 纵向:模块负责人制
把模块分成两组,每组绑定一个产品 + 一个研发,结对推进该组所有 Spec 的状态机:
- 模块产品负责人:需求录入、业务确认、验收。
- 模块研发负责人:技术校准、实现、提审。
- 每份 Spec 的负责人字段写实,项目总览的负责人表同步。
3.2 横向:全局物各有单一维护人
| 全局物 | 维护人 | 变更规则 |
|---|---|---|
.ai/TECH-STANDARDS.md |
研发甲 | 两位研发都确认后改(影响双方代码) |
.ai/DESIGN-STANDARDS.md |
产品甲 | 两位产品都确认后改 |
specs/project-overview.md |
负责人 | 追加型,随时改 |
| 部署与运行事实(见第 7 节) | 研发甲 | 两位研发都确认后改 |
原则:模块内自主,全局基线共识。模块内部实现细节负责人自己定;凡写进全局基线的必须一致。
3.3 交叉制衡(推荐做法)
- 审查交叉:推荐研发甲实现的由研发乙审、研发乙实现的由研发甲审。交叉的价值不在挑代码毛病,而在带来另一份需求理解和模块知识,最容易抓到理解偏差和跨模块影响。
- 发布交叉:推荐模块研发负责人准备发布单、另一位研发按清单核对——准备的人想上线,核对的人负责说"等等"。
- 交叉同时是容灾:互相看过对方代码,任何一人请假项目可续。
4. 需求循环:一个需求的完整旅程
以 M1「批量导出」为例(下表是一次完整循环,量级 1 天~2 周):
| 步骤 | 谁 | 动作 | 产出 |
|---|---|---|---|
| 1 录入 | 产品甲 | 查项目总览定归属;已有模块加版本,新模块先占号(见 4.1);提交并推送 | M1 v1.3 草稿 |
| 2 业务确认 | 产品甲 | 确认场景、规则、验收条件,对照 Spec 生成的业务图(见 4.2);状态改"待研发校准" | — |
| 3 技术校准 | 研发甲 | 评估接口 / 数据 / 权限 / 兼容 / 工期;用「Spec 生成 ↔ 代码逆向导出」的 diff 校验(见 4.2);跨模块则申报(第 6 节);结论写 Spec 技术附录,业务冲突列未决问题 | 技术附录 |
| 4 基线确认 | 产品甲 + 研发甲(跨模块四人) | 关闭阻塞性未决问题;版本表写版本号 + 确认人;复制快照到 specs/history/M1-文档管理/v1.3.md;提交主干 |
已基线 |
| 5 实现 | 研发甲 | 按第 5 节并行开发 | 分支 + 合并请求 |
| 6 测试样例 | 产品甲 + 研发甲 | 按 .ai/TEST-STRATEGY.md 在 tests/cases/ 建样例(对应场景/验收编号),执行并记录结果 |
样例 + 结果 |
| 7 审查 | 研发乙(推荐交叉) | 按 .ai/REVIEW-GATE.md 四条深查路径审分支差异,合并请求里留问题清单和证据 |
审查记录 |
| 8 验收 | 产品甲 | 按验收条件逐项验收;偏差记 Spec 未决问题 | 已验收 |
| 9 发布 | 见第 7 节 | — | 发布单 |
需求变更 = 同一份 Spec 加版本(v1.4)+ 变更记录,状态回到待产品确认或待研发校准,旧快照不动。判断标准:用户可见行为变了就走变更,与技术量大小无关。
4.1 两个产品并行录入的细则
- 占号:开新模块先在项目总览登记模块名、编号、负责人并提交,再建
specs/M{N}-{name}.md。两人同时开新模块时,后提交的在索引上产生版本冲突——这是信号不是事故,两边条目都保留即可。 - 去重:判断"是否同一用户行为",与录入入口和录入人无关。草稿期撞车直接并入同一份草稿(来源都记);已基线后发现重叠,后到的走变更流程;两份 Spec 写着发现是一回事,保留已基线的那份(都没基线保留编号小的),另一份标记废弃并在开头指向保留份。
- 落在别人模块的需求:转原始诉求(保留原话和来源)给该模块产品负责人由他建档;或代建草稿并标"待负责人确认"。不要两边各建一份。
4.2 确认与校验怎么落地:看生成物,不啃文档
让人生读 Spec 全文做确认是全流程最薄弱的一环:人会跳读,会"看过当确认过",产品面对技术附录更容易看不懂。所以确认的标准动作不是"读文件",而是让 Agent 把 Spec 和代码各渲染成图和报表,人看对比结果。
两个来源、一个对比:
| 来源 | 生成什么 | 代表 |
|---|---|---|
| 从 Spec 生成 | 业务图:用户操作路径图、状态图、页面流程图、验收覆盖表;技术图:ER 图(表关系图)、接口定义表、时序图(出自技术附录) | 应该是什么样 |
| 从代码逆向导出 | 现状报表:真实表结构、接口列表、模块依赖图 | 实际是什么样 |
对比出的差异只有三类,每类有固定去处:
- 缺(Spec 有、代码没有)→ 未实现完,打回;
- 多(代码有、Spec 没有)→ 多出来的行为:要么补进 Spec,要么删代码;
- 错(两边都有但对不上)→ 定义与实现脱节,最危险也最容易被读文档漏掉,优先处理。
三个环节各看什么:
- 产品确认(表内步骤 2):Agent 先按
.specs/checklists/spec-checklist.md的「产品确认」清单自查补缺,再从场景 / 验收条件生成业务图。产品看图回答三个问题:流程对不对、状态全不全(异常、无权限画出来了吗)、边界清不清(做什么和不做什么)。完成 = 状态改"待研发校准"并提交。 - 研发校准(表内步骤 3):Agent 从技术附录生成 ER 图、接口定义表、时序图,同时扫现有代码逆向导出表结构报表和接口列表,并跑一遍 diff 列出缺 / 多 / 错三列。研发裁决:差在哪、要不要数据迁移、波及谁;业务冲突写进未决问题,退回产品确认,不擅改业务部分。
- 基线确认(表内步骤 4):形式前置(状态正确、阻塞项清零、技术附录已填)由 Agent 检查,缺项即停;当期生成物随快照一起归档到
specs/history/{模块}/{版本}/,之后的争议直接比图。Agent 只代填确认人姓名,不代替双方做确认判断。
三条原则:
- 生成物是衍生视图,不是第二事实源。Spec 和代码仍是唯二事实;图按需重新生成,不手工编辑、不单独维护——否则违反铁律二,两份图漂移比两份文档更迷惑。
- 生成必须可重复。用固定提示词或脚本:图用 mermaid(流程图、erDiagram、时序图),接口用表格或 OpenAPI,报表用脚本。生成不稳定的东西宁可不上。
- 关键节点生成,不常态化。只挂三道门:产品确认、基线确认、发布核对(发布时加环境配置和迁移 diff 报表)。日常录入不生成,控制成本。
目录约定(已写进 kit,生成物不散落根目录):
specs/                                # 需求事实(提交)
├── M1-文档管理.md
└── history/M1-文档管理/
    ├── v1.3.md                       # Spec 快照(提交,只读)
    └── v1.3/                         # 当期生成物副本(提交,版本证据)
prototypes/M1-文档管理/                # 原型:被评审、随 Spec 同步的工作产物(提交)
generated/M1-文档管理/                 # 校验生成物:纯衍生视图(.gitignore,可整目录删除重生成)
├── journey.png / er.mmd / api.md     # 从 Spec 生成
└── reverse/schema.md / routes.md     # 从代码逆向导出
三条规则:
- 原型和校验生成物是两类东西:原型要被产品评审、随 Spec 版本同步维护(变更同步清单里有它),所以进版本库;校验生成物看完即弃,不进版本库。
generated/整目录随时可删:删掉无任何损失,Agent 在下一次确认门重新生成;它已在 kit 的.gitignore模板里,手工编辑没有意义。- 证据留在 history:基线确认时 Agent 把当期关键生成物复制进
specs/history/{模块}/{版本}/——工作区那份随删随生,历史里那份是版本证据,之后争议比这一份。
人机分工:Agent 负责生成和初筛(把缺 / 多 / 错三列差异表列好),人只做裁决——尤其"多的这个要不要留"。形式工作在 Agent,实质判断在人,与基线确认的边界原则一致。
4.3 实操示例:产品怎么录需求,研发怎么定技术方向
两个例子沿用 M1「批量导出」这条线(产品甲 + 研发甲),展示从"开口说"到"落文件"的完整过程。提示词改花括号就能用。
示例一:产品录入一条需求(约五分钟)
背景:产品甲在运营群里收到一句话——"导出太慢,想一次选多个文档一起导"。
第一步,直接对 Agent 说(改写 .ai/PROMPT-USAGE.md 第 2 阶段模板):
我收到 2026-10-03 运营群的需求:"导出太慢,想一次选多个文档一起导"。请在
specs/M1-文档管理.md加 v1.4:保留原话,整理用户场景、业务规则、F/AC 和未决问题。不知道的标"待确认",不要编接口和数据表。先给我看业务部分。
Agent 产出的草稿长这样(节选):
## v1.4 变更记录
- 来源:运营群 / 2026-10-03;原话:"导出太慢,想一次选多个文档一起导"

### F03 批量导出文档
用户在文档列表勾选多个文档,一次导出为压缩包。
- AC1:列表提供多选,单次可选数量上限为 {待确认}
- AC2:导出为 zip,文件名保留原名
- AC3:无权限的文档自动跳过,并在结果中提示

### 未决问题
- 单次批量上限(10 / 50 / 不限?)——待产品确认
- 导出格式是否与单篇导出一致——待产品确认
第二步,产品本人只判断三件事(就是 4.2 的三个问题):
- 场景真不真:运营要的是"多选打包",不是"单个导出提速"——原话容易被误读,场景写对了才敢确认;
- 边界清不清:上限、格式两个待确认项就是边界,现在拍板(比如定 50、格式一致),让 Agent 补进 AC;
- 验收能不能测:每条 AC 都可观察(能勾选、zip 里文件名对、跳过有提示),而不是"导出体验更好"这种没法验的。
第三步,收尾三动作:状态改「待研发校准」→ 让 Agent 按 spec-checklist 自查 → 提交推送。之后等研发校准,参加 15 分钟基线确认,实现完按 AC 逐条验收——产品的活就干完了。
三条纪律:信息不全也先建档(标待确认);不编造接口和数据表(那是研发的事);原话永远保留(争议时它是证据)。
示例二:研发设定技术方向
分两层:项目级的技术基线(一次),需求级的技术校准(每条需求一次)。
项目级——启动时填 .ai/TECH-STANDARDS.md(对应 2.1 步骤 2)。研发甲对 Agent 说:
项目选了 FastAPI + Vue 3。请按
.ai/TECH-STANDARDS.md的表格起草技术基线:后端 Python 3.12 / FastAPI / PostgreSQL,前端 Vue 3 + Element Plus,分层和命名参照.ai/prompts/fastapi-guide.md与vue-guide.md的默认约定。已有代码以现状为准,不确定的标待确认。
研发甲核对草稿后定稿长这样(节选):
| 层 | 框架及版本 | 环境 / 命令 | 负责人 |
|----|-----------|------------|--------|
| 后端 | Python 3.12 · FastAPI 0.115 · SQLAlchemy 2(async) | uv · ruff check · pytest | 研发甲 |
| 前端 | Vue 3.4 · Element Plus 2.x · Pinia | pnpm · vue-tsc · vitest | 研发甲 |
| 数据库 | PostgreSQL 16 · Alembic | alembic upgrade head | 研发甲 |

- 数据访问模式:异步 SQLAlchemy;删除策略:软删除
- 任务队列与缓存:暂不使用(导出量大时再评估)
两个关键动作:
- 指南默认 ≠ 项目事实。软删除是指南里的默认做法,写进基线才成为本项目的决定;任务队列"暂不使用"也要写明——空白会诱导后人随手引入。
- 全局项须共识。表里所有内容影响两位研发,定稿前和研发乙过一遍再提交(3.2 的规则)。
需求级——每条需求基线后做技术校准(第 4 节表步骤 3)。M1 v1.4 产品确认后,研发甲对 Agent 说:
基于已确认的 M1 v1.4,检查现有代码和
.ai/TECH-STANDARDS.md,校准批量导出的接口、数据、权限和测试方案,写进 Spec 技术附录。先按 4.2 生成接口定义和表结构现状(Spec 生成 ↔ 代码逆向导出),diff 列出缺 / 多 / 错。业务冲突(如上限 50 对 AC 的影响)列未决问题交产品。
产出落进 Spec 技术附录:新增接口 POST /api/document/export-batch、打包逻辑放服务层、权限过滤复用现有数据范围;若导出完成要发通知,触发第 6 节的跨模块申报。
两个示例是同一个道理:人对 Agent 说的每句话都只是指令,落进文件的内容才是事实。录完、校准完,自己去读一眼 Spec 和基线,确认它们说的是你想要的。
5. 并行开发与合并管理
5.1 何时开分支 / 多工作区
- 单需求单人改:普通分支足够,
feat/M1-batch-export。 - 同模块多需求并行、或同仓库前后端同时改:多工作区(命令见
.ai/WORKTREE-WORKFLOW.md)。 - 跨模块依赖、不可逆迁移、重要取舍、多人并行:先写技术方案(现状、方案、文件归属、风险、验证),跨人依赖用任务清单记。
5.2 一个实现的日常节奏
git pull                                    # 改前拉取
git switch -c feat/M1-batch-export
# 实现;契约有变则同步更新 Spec 技术附录
git add -A && git commit -m "M1 v1.3 批量导出:…"   # 小步提交
# 自查 .specs/checklists/code-checklist.md,跑测试
git push -u origin feat/M1-batch-export     # 发起合并请求
合并请求描述必须包含:依据的 Spec 版本、测试结果、遗留风险。审查人核对实现与 Spec 版本一致。
5.3 合并管理:三层分开看
| 层 | 场合 | 方式 | 冲突处理 |
|---|---|---|---|
| Spec 文档 | 产品录入 / 变更 | 直进主干,小步 | 不同模块文件不相交,零冲突;撞同一份见 5.4 |
| 共享索引 | 项目总览 / 依赖表 | 直进主干 | 追加型数据,两边都保留 |
| 实现代码 | 分支完成 | 合并请求 + 交叉审核(推荐) + 合并 | 常规变基解决 |
跨模块需求的合并顺序:接口定义先合——M1 的接口 / 事件变更先合入主干,M2 的适配分支变基到新主干后再提合并请求。顺序在技术方案里写死,不临场商量。
5.4 真的撞了同一份 Spec 怎么办
甲乙都不小心改了 specs/M1-文档管理.md,后者拉取时:
- 改的是文件不同区域:版本工具自动合并,无感。
- 相同或相邻行(版本表、变更记录这些追加点最容易):
CONFLICT (content): Merge conflict in specs/M1-文档管理.md
文件里出现 <<<<<<< 本地 … ======= … >>>>>>> 远端 标记,两边内容都不会丢。处理:
git status                                  # 看哪个文件冲突
# 编辑文件:以 M1 的模块负责人(产品甲)的修改为版本线主体;
#   产品乙的有效诉求并成变更记录里的一条来源;误改直接丢弃(git checkout --theirs 该文件)
git add specs/M1-文档管理.md
git commit && git push
不想到场解决:git merge --abort 回到拉取前状态,与产品甲对齐后重来。事后复盘:撞同一份 Spec = 归属规则被突破的信号,查一下谁越界了。
6. 跨模块变更:申报—签收
M1 的改动波及 M2 时(例:导出格式变更影响通知内容):
- 申报:产品甲在 M1 的变更记录里写"疑似影响 M2 的 F05"。不确定也先写"疑似",判断责任不压在产品一人身上。
- 评估:研发甲技术校准时确认波及面(接口 / 事件 / 数据),结论写回 M1 变更记录。
- 签收:产品乙在 M2 的 Spec(不是 M1)加影响记录,只写一句引用:"因 M1 v1.3 变更,F05 需适配,见 M1 变更记录"。与研发乙商定响应:同步改 / 下版本改 / 反弹。三种都合法,不响应不合法。
- 升级确认:M1 该版本能基线的前提 = M2 影响记录已落地(签收即通知机制)。基线确认升为四人,技术侧因跨模块依赖触发技术方案(Plan)。
- 有序实现:先契约后实现(5.3),文件归属和合并顺序写进技术方案。
争议:产品乙认为变更伤害 M2 业务时,冲突记入 M1 未决问题,两方产品 + 相关研发裁决;定不下就挂起,挂起期间 M1 该变更不能基线——受影响方有否决权。
防漏报:变更时让 Agent 按项目总览的模块依赖表评估波及面;审查门禁的"变更影响"深查路径是第二道网。
7. 发布上线
kit 当前生成包不含发布文档;在本手册对应文件进入 kit 之前,按本节规则执行。
状态延长:已验收 → 待发布 → 已发布 → 观察期 → 已关闭。
三道门(每道都是清单 + 证据留痕):
- Spec 交接自检(
.specs/checklists/spec-checklist.md)——基线时; - 审查门禁——提审时;
- 发布清单——上线前:目标版本与负责人、测试与构建证据、配置密钥可用性、数据迁移兼容、健康检查、回退步骤。原则:没有数据库、灰度、容器编排或持续集成时,不要为了清单引入它们。
发布单(建议 specs/releases/R{N}.md):版本号、包含的 Spec 版本清单(引用快照路径,不复制内容)、测试证据、部署内容(标签 / 提交 / 环境)、审批人、回滚方案、观察期结论。
分工:模块的研发负责人准备发布单 → 推荐另一位研发按发布清单交叉核对 → 产品负责人做上线前业务验收。
观察期(如 24~72 小时):盯关键指标与日志,问题记入发布单;无异常后标记已关闭。发现阻断性问题:按预案回滚,回滚动作本身也记入发布单。
线上问题回流:缺陷或行为偏差 → 该模块 Spec 加版本(或记未决问题)→ 走第 4 节需求循环。上线不是终点,回流闭环才是。
部署事实登记:环境清单、部署方式、构建 / 启动 / 健康检查命令、配置与密钥管理、日志监控,集中登记(建议 .ai/OPS-STANDARDS.md,仿技术基线的待填写表格模式),发布前由 Agent 按它核对。
8. 协作节奏(参考)
- 每天:各自模块走循环,文件交接,无例会。
- 每需求:基线确认,组内两人,15 分钟级。
- 每周一次 30 分钟:过一遍项目总览——新模块、依赖表变化、待签收的跨模块变更、下个发布窗口。
- 发布:按需,提前一天挂发布单。
原则:例会只做文件解决不了的事(排期冲突、争议裁决、优先级取舍);信息同步靠文件,不靠开会。
9. 避坑清单
- 别憋大招。攒一大段再推送 = 冲突窗口放大 + 审查变痛苦。小步是纪律,不是风格。
- 别让同一行为存在两份 Spec。多人录入最大的灾难源,发现即按 4.1 去重。
- 别跳过基线直接开发。未基线的 Spec 可以做原型和探索,不能当交付契约。
- 别让审查走过场。审查人必须按清单产出问题清单,合并请求里留证据,否则等于没审。
- 别复制内容做交接。引用模块名 + 版本号;两处复制的内容必然漂移。
- 口头结论当天回写。会上的决定不留到明天,忘了 = 没发生。
- 挂起优于带病基线。阻塞性未决问题清不掉就不基线,宁可晚。
- 容灾靠机制不靠人。交叉审查 + Spec 快照 + 版本化文件 = 换人、换会话、换 Agent 工具都能续。
- 老产品接入别抄代码。观察到的行为不自动等于批准的需求,每条经产品确认才能进 Spec(见 2.2)。
10. 速查卡
| 类别 | 条目 |
|---|---|
| 铁律 | 文件即事实 / 单一事实源 / 版本线性追加 / 模块负责人制 / 交叉审核 / 先契约后实现 / 小步提交 |
| 纪律 | 改前拉取改后推送 / 建档即提交 / 口头当天回写 / 模块内自主全局共识 / 不带病基线 / 例会只做文件解决不了的事 |
| 状态机 | 草稿 → 待产品确认 → 待研发校准 → 已基线 → 实施中 → 已验收 → 待发布 → 已发布 → 观察期 → 已关闭 |
| 谁审谁 | 推荐交叉:研发甲实现研发乙审、研发乙实现研发甲审;发布单同理;局部修复可自查 |
| 冲突口诀 | 索引两边都留;同份 Spec 以模块负责人为准;中止合并可重来 |
| 确认口诀 | 看图不啃文档:Spec 生成 ↔ 代码逆向导出,diff 找缺 / 多 / 错 |
AI 编程工具
命令行 Agent 是当前主流:能力强、可脚本化,天然适配本套文件的工作流。选哪个不重要,入口文件都是同一套。
还值得接入的 MCP
联网搜索、网页读取、图像理解、项目记忆——这些能力主流 Agent 已经内置(记忆就是 CLAUDE.md / AGENTS.md 这套入口文件),对应的 MCP 不用再装。MCP 现在的价值是连接 Agent 够不到的数据和系统。
tests/cases/ 样例做 UI 回归。.ai/DESIGN-STANDARDS.md 对接真实设计系统。Skills 怎么选
写 commit 信息、生成 PR 描述、代码审查、简化重构、定位 Bug——这些单一用途的小技能,2026 年的模型已经内置,直接对话就能做好,不必再装。Skill 留给两类:复杂多阶段流程,和团队自有规范的封装。